OpenAI 文字浮水印開放 API 自選啟用:一般人能驗嗎?看懂入口與限制
OpenAI 10 月 5 日公布 textGrain,全球 API 客戶可為部分模型開啟文字浮水印,EU 的 ChatGPT/Codex 則將分階段導入。從官方設定畫面與兩張評估圖,了解怎麼啟用、誰能申請偵測,以及結果不能證明什麼。
本文導覽
在 OpenAI API 裡替文字加上來源訊號,現在有了官方開關。OpenAI 於 2026 年 10 月 5 日公布 textGrain 文字浮水印:全球 API 客戶可為部分模型自行啟用,預設維持關閉;歐盟的 ChatGPT 與 Codex 合資格文字輸出,則預計在未來幾週分階段導入。
對想拿一段文字來查驗的人,最重要的差別是:能開啟浮水印,不代表能使用文字偵測器。偵測權限初期採申請審核,開放給獲准的研究者與專業組織;目前沒有人人都能貼上文章、立即查驗的公開文字入口。以上範圍依 OpenAI 10 月 5 日公告,並非全球 ChatGPT 已全面套用。
官方入口與文件
- OpenAI API 組織設定入口(需登入與適當權限)
- 浮水印設定與判讀說明
- 文字偵測器申請表(資格審核,非即時檢測工具)
本文於台灣時間 10 月 6 日查核公開文件。未登入變更帳戶設定、呼叫偵測 API 或進行生成測試;下方皆為 OpenAI 官方圖片與評估,非本站實測。
API 怎麼開?先看組織預設,再看專案設定
官方操作說明提供兩層設定:
- 組織預設:進入 Organization settings → Data controls → Text provenance。
- 個別專案:進入該專案的 Project Settings → Text provenance,可覆蓋組織預設。
- 開啟 Allow text watermarking,選擇支援的模型,再按 Save。
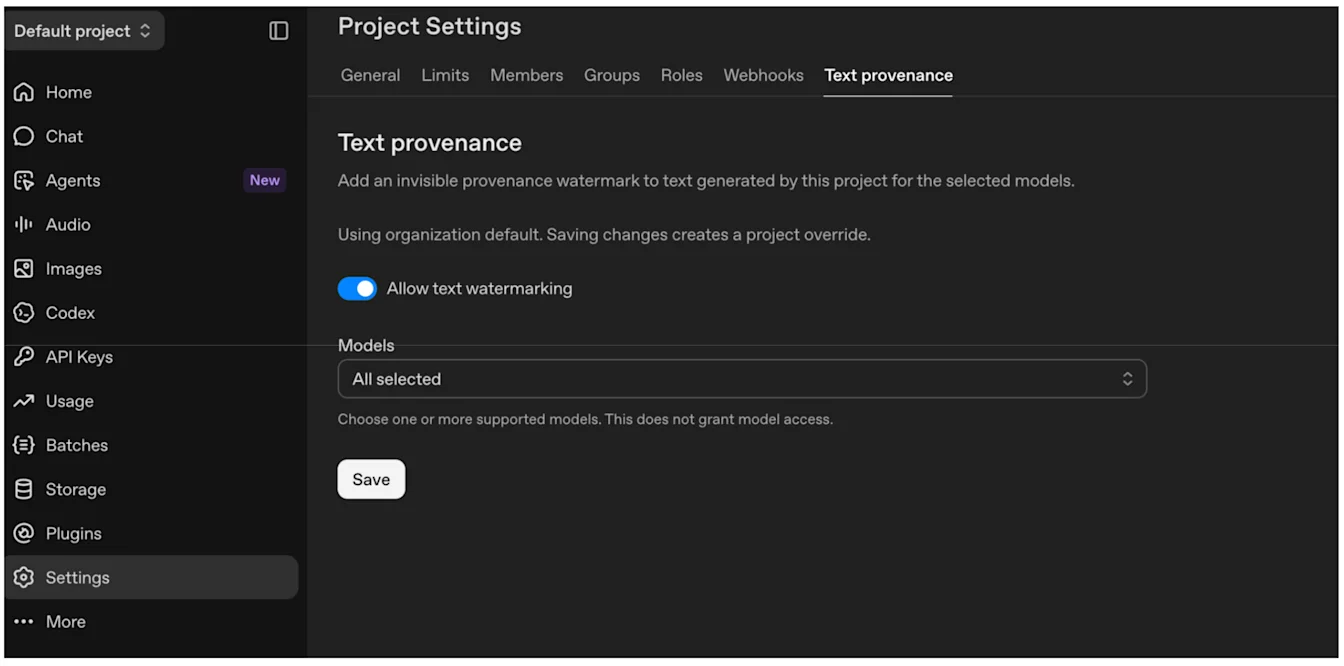
實際支援清單以設定頁為準,不宜把圖中的「All selected」理解成所有 OpenAI 模型都已開放。台灣的一般 ChatGPT 使用者,也不能由這次 EU 公告推定自己的聊天輸出已有浮水印。
綠豆的使用建議是,若你管理既有 API 應用,先確認要調整哪個專案與模型,記下原設定,再評估是否適合服務的來源揭露方式。本文查核的公告與說明未提供可核實的文字浮水印專屬費率,因此不把它標成免費,也不猜測額外費用。
浮水印藏在用字規律裡,複製貼上不會冒出隱藏字元
textGrain 會微調模型選擇字詞或詞片段時的隨機機率,讓一段文字累積可供偵測的統計訊號。依官方說明,它不會塞入隱藏字元、透明空格或專為浮水印增加的 tokens。
這也解釋了為什麼只靠肉眼看格式找不到它。對網站編輯而言,保留原始輸出與自己的修改紀錄,仍比猜測某個標點是不是「AI 記號」有用。文章內容是否正確,則需要另外查證。
兩張官方圖告訴我們:長度、題型與修改都會影響偵測
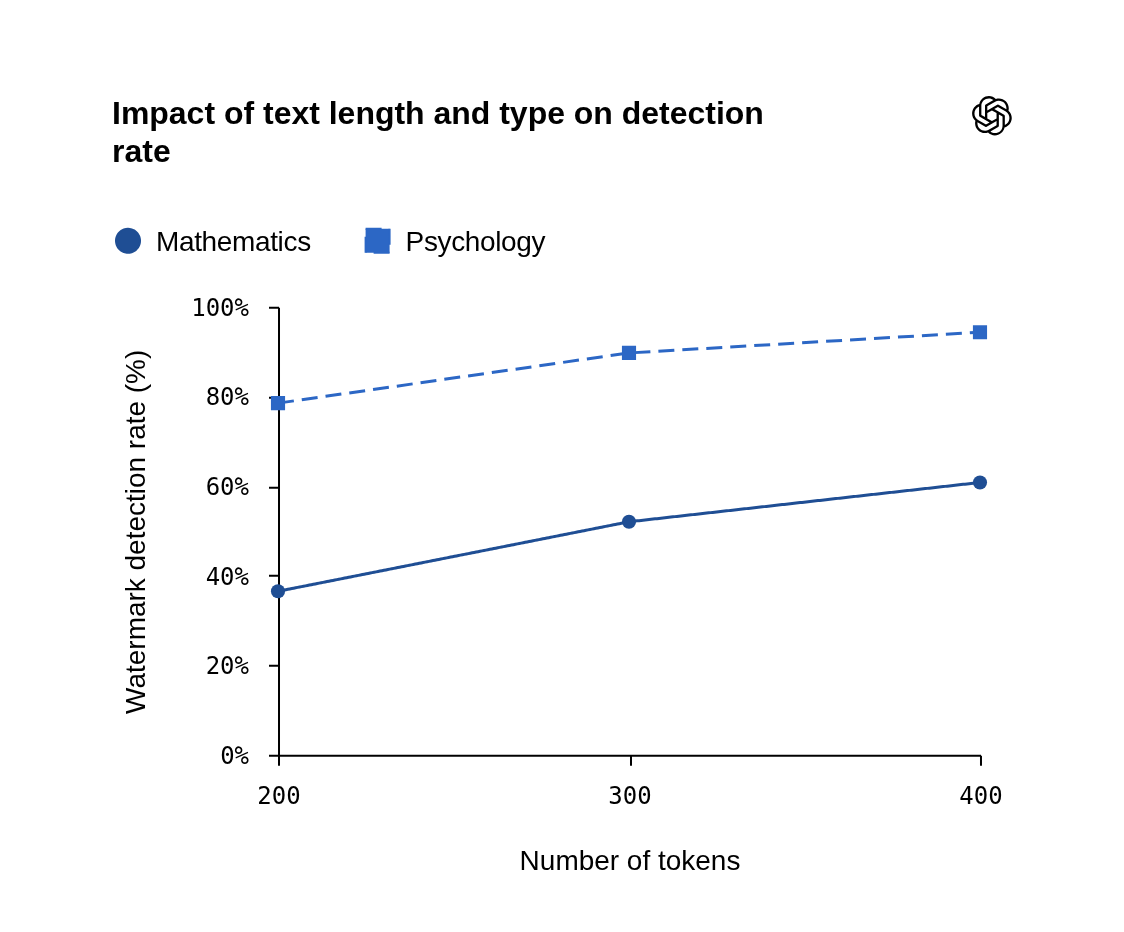
先看長度圖。同樣是已加浮水印的回答,心理學與數學題的偵測率相差很大。這裡的 token 是模型處理文字的單位,不能直接換算成相同數量的中文字。
再看編輯圖。它採用另一批回答,不能把未編輯的起點直接與上一張圖混用。
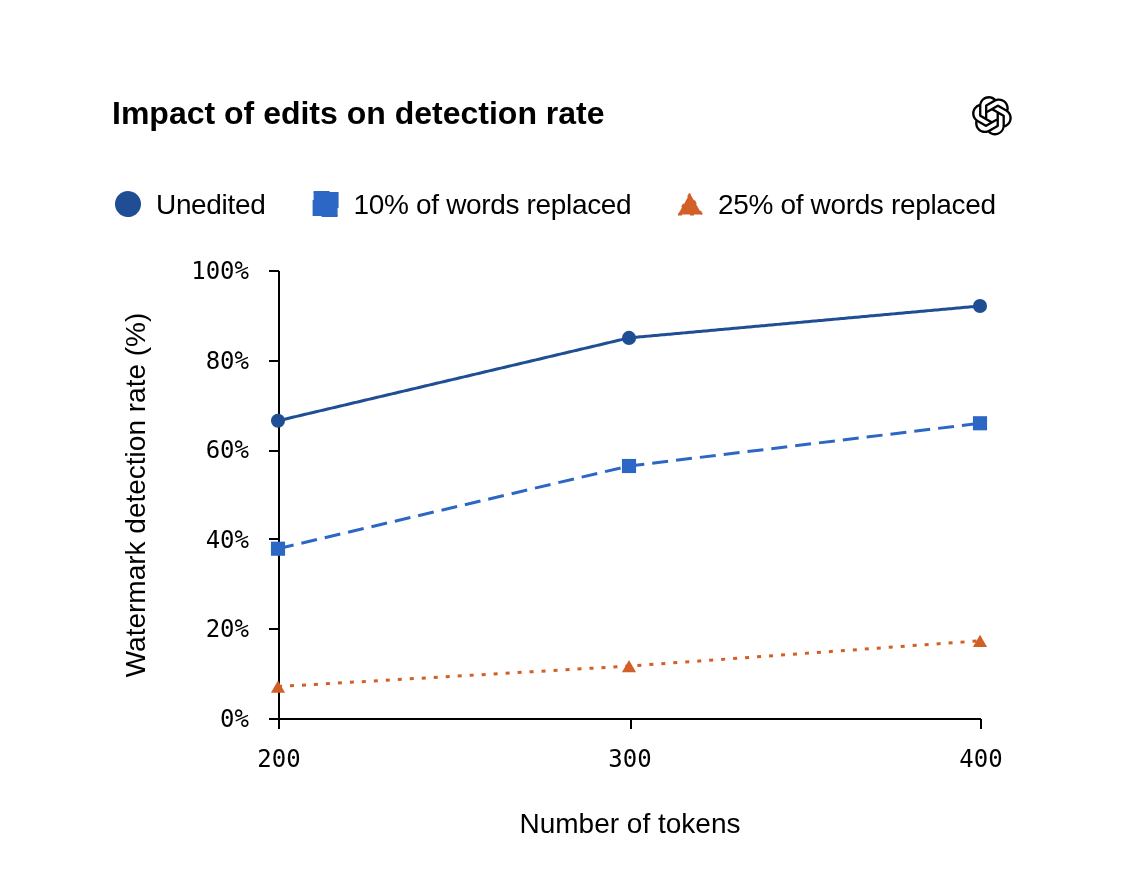
讀圖時,請把「目標誤判率 1%」和「偵測率」分開。前者是評估採用的錯誤警報門檻,後者是特定已加浮水印樣本被找到的比例;兩者都不是某篇文章由 AI 寫成的機率。短文、程式碼、用字受限的答案,以及翻譯或大幅改寫,還可能讓訊號更難辨識。
一般人能去哪裡驗?文字仍須申請資格
官方申請表可提出文字偵測需求,由 OpenAI 逐案評估;送出不代表取得權限。現有 Content Provenance API 公開文件主要介紹圖片與音訊檢查,另列文字權限申請。不能把圖片/音訊驗證入口當成公開文字偵測器。
若你只是想查一篇網路文章,這次公告還沒有提供可立即使用的全民文字檢測服務。若你代表符合研究用途的組織,則可先讀申請條件,說明研究問題與預計用途;不要先把私人文章、客戶內容或對話交給來路不明的檢測網站。
偵測結果只能提供線索,不能替作者身分下結論
- 找到訊號:表示有與 OpenAI 浮水印相符的跡象,仍須考慮誤判;不能由此得知是哪個人、帳戶或提示詞,也無法計算人類貢獻比例。
- 沒找到或結果不明:不能證明文章是人寫的。可能涉及未支援模型、未啟用時生成的內容、其他公司的工具,或訊號已受改寫影響。
- 無論結果如何:都不能單憑它證明內容真實、抄襲、所有權或法律責任。
這些邊界也是官方公告特別提醒的限制。綠豆的判讀建議是:看見檢測報告時,先問使用哪一種工具、對象是否在支援範圍、文字是否經過修改,再回到原始資料與版本紀錄。浮水印可以補充來源線索;人的創作、查證與責任,仍需要更完整的脈絡。